OpenJarvis: 개인 AI는 클라우드가 아니라 내 컴퓨터에서 돌아가면 됩니다
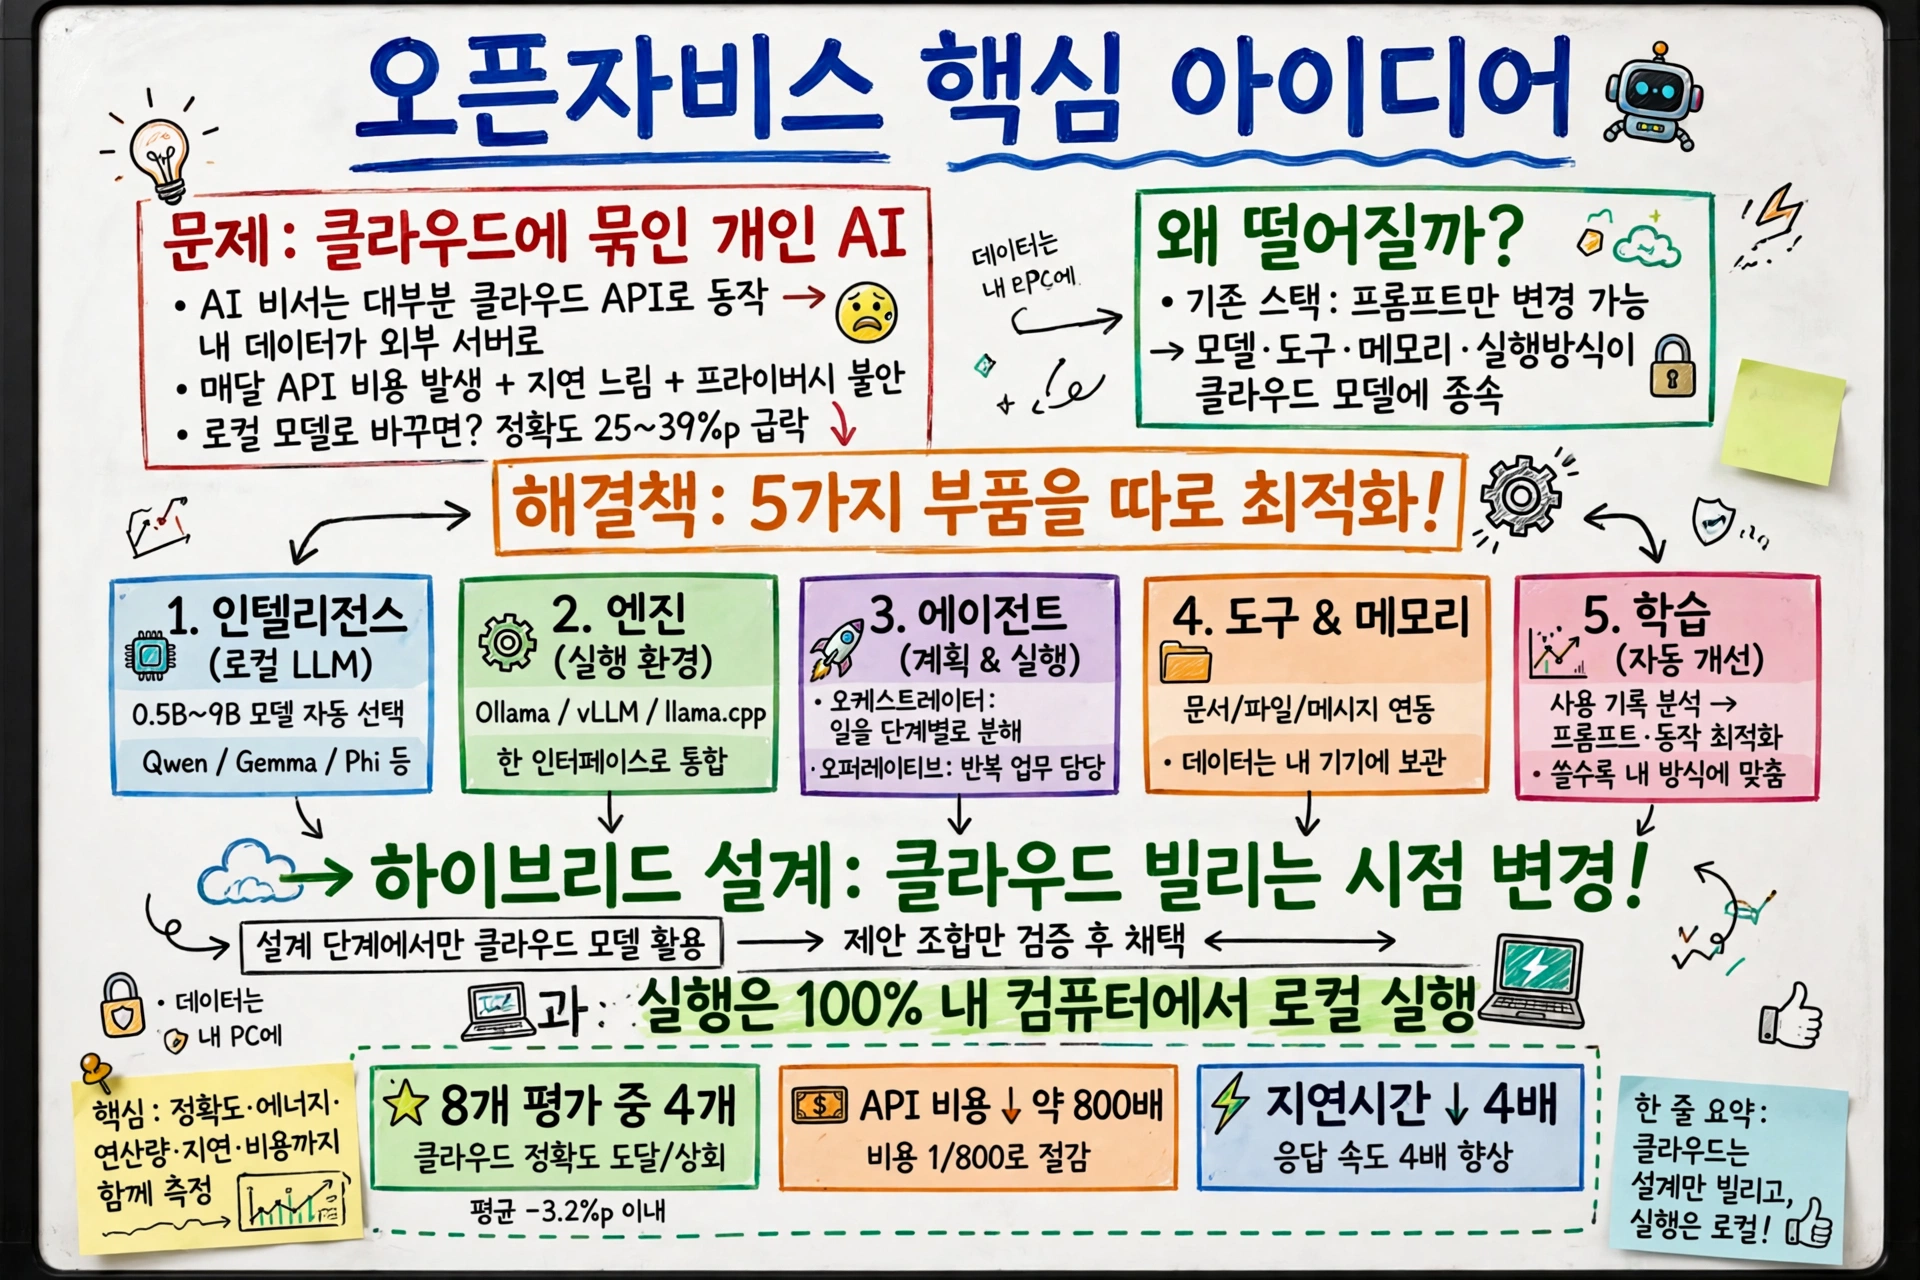
Summary 오픈자비스는 로컬 모델과 도구, 메모리, 에이전트, 학습을 독립적으로 최적화해 개인 AI를 내 기기에서 실행하는 오픈소스 프레임워크입니다. 평가 8개 중 4개에서 클라우드 수준의 정확도를 달성하면서 API 비용을 약 800배, 지연 시간을 4배 줄였으며, 설계 단계에는 클라우드를 활용하되 실제 추론은 로컬에서 수행합니다.
- 오픈자비스는 개인 AI 에이전트를 클라우드가 아니라 내 컴퓨터에서 직접 실행하는 오픈소스 프레임워크입니다.
- 로컬 모델로 바꾸면 정확도가 크게 떨어지는 문제를, 다섯 가지 구성 요소를 따로 최적화하는 방식으로 풀었습니다.
- 그 결과 8개 평가 중 4개에서 클라우드 수준에 도달했고, API 비용은 약 800배, 지연 시간은 4배 줄었습니다.
AI 비서에게 이메일을 정리해달라고 부탁했는데, 내 메일 내용이 먼 서버로 날아간다는 생각에 찜찜했던 적 있으시죠? 편하긴 합니다. 그런데 매달 사용료가 나가고, 내 데이터는 내 손을 떠납니다. 이 찜찜함을 없애는 방법이 있습니다. AI를 아예 내 컴퓨터 안에 들이는 겁니다!
🎥
왜 개인 AI는 아직 클라우드에 묶여 있을까요?
요즘 개인 AI 비서는 대부분 클라우드 API에 기대어 돌아갑니다. 내 컴퓨터는 질문을 전달하는 창구일 뿐이고, 실제 생각은 남의 서버에서 일어납니다. 그러니 응답이 느려질 때가 있고, 쓸 때마다 요금이 쌓이고, 민감한 내 문서가 외부로 나갑니다.
개인 비서라면서, 정작 내 일은 남의 컴퓨터에서 처리하고 있는 셈입니다.
최근 인기를 끈 오픈클로 같은 개인 비서 도구들도 대부분 클라우드에 기댑니다. 그런데 연구팀이 주목한 건 따로 있었습니다. 로컬 언어 모델과 로컬 가속기는 이미 한 번의 질문과 추론 작업 중 88.7%를 사람이 체감하는 속도로 처리할 수 있었습니다. AI 효율성은 2023년부터 2025년 사이 5.3배나 좋아졌고요. 모델과 하드웨어는 이미 준비됐는데, 로컬에서 AI를 제대로 굴릴 소프트웨어 스택이 없었던 겁니다.
로컬 모델로 바꾸면 왜 정확도가 떨어질까요?
그냥 모델만 바꾸면 안 됩니다. 최상급 클라우드 모델을 9B급 로컬 모델로 바꾸면 개인 AI 작업에서 정확도가 25~39%p나 떨어진다는 측정 결과가 있습니다. 프롬프트만 다듬는 최적화로는 그 격차 중 5%p밖에 메우지 못했고요.
문제는 구조에 있었습니다. 기존 스택은 프롬프트, 도구 설명, 메모리 설정, 실행 방식을 특정 클라우드 모델 하나에 묶어두는 방식입니다. 바꿀 수 있는 건 프롬프트뿐이었으니, 로컬 모델은 제 실력을 낼 틈이 없었던 겁니다.
다섯 가지 부품을 따로 조립하면 어떻게 될까요?
오픈자비스는 개인 AI 시스템을 다섯 가지 구성 요소로 나눕니다. 각 요소는 따로 떼어 측정하고, 바꾸고, 최적화할 수 있습니다. 정확도만 보는 게 아니라 에너지, 연산량, 지연 시간, 비용까지 함께 잽니다.
로컬 언어 모델] --> B[엔진
추론 실행 환경] B --> C[에이전트
계획과 실행] C --> D[도구와 메모리
문서·메시지·파일] D --> E[학습
사용 기록으로 개선] E --> A
첫째, 인텔리전스는 로컬에서 도는 언어 모델입니다. 필요한 성능만 정하면 내 컴퓨터 사양에 맞는 모델을 자동으로 골라줍니다. 0.5B부터 9B까지, Qwen, Gemma, Phi 같은 모델이 들어갑니다.
둘째, 엔진은 모델을 실제로 돌리는 실행 환경입니다. Ollama, vLLM, llama.cpp 같은 로컬 실행 도구를 하나의 인터페이스에서 쓸 수 있습니다.
셋째, 에이전트는 일을 계획하고 수행하는 구조입니다. 오케스트레이터 에이전트는 복잡한 일을 여러 단계로 나누고, 오퍼레이티브 에이전트는 반복되는 개인 업무를 맡습니다.
넷째, 도구와 메모리는 내 환경과 연결되는 부분입니다. 문서를 검색하고 파일을 읽고 메시지 서비스와 연동합니다. 데이터는 기본적으로 내 기기에 남습니다.
다섯째, 학습은 사용 기록을 분석해 프롬프트와 에이전트 동작, 모델 선택을 자동으로 다듬는 구조입니다. 쓰면 쓸수록 내 방식에 맞춰집니다.
클라우드는 설계할 때만 빌리면 되지 않을까요?
여기가 가장 재밌는 지점입니다. 오픈자비스는 클라우드를 아예 끊지 않습니다. 빌리는 시점을 바꿉니다. 대형 클라우드 모델은 설계 단계에서만 불러서 다섯 가지 구성 요소를 어떻게 조합할지 제안하게 하고, 나빠지지 않는 제안만 받아들입니다. 그리고 실제 실행은 온전히 내 기기에서 합니다. 클라우드를 아예 끊는 게 아니라, 빌리는 시점을 바꾸는 겁니다!
설계 단계에서만 제안] --> B[나빠지지 않는
제안만 채택] B --> C[완성된 설계] C --> D[내 기기에서 실행
추론은 온전히 로컬]
결과가 숫자로 나왔습니다. 온디바이스 실행만으로 8개 평가 중 4개에서 클라우드 정확도에 도달하거나 앞섰고, 평균으로는 최고 클라우드 기준과 3.2%p 안에 들었습니다. API 비용은 약 800배, 지연 시간은 4배 줄었습니다!
평가 기준도 다릅니다. 정확도만 재는 게 아니라 에너지 소비와 연산량, 응답 지연 시간, 쿼리당 비용을 함께 측정합니다. 엔비디아 GPU, AMD GPU, 애플 실리콘까지 하드웨어별 에너지 사용량을 추적하는 텔레메트리도 들어 있습니다.
아침 브리핑은 어떻게 돌아갈까요?
오픈자비스에는 8개의 내장 에이전트가 있습니다. 주문형, 예약형, 지속형 세 가지 실행 방식에 나뉩니다. 아침 브리핑 에이전트는 이메일과 일정, 건강 정보, 뉴스를 읽어서 음성 브리핑을 만들어줍니다. 스케줄러에 “매일 아침 7시에 일정 확인, 이메일 점검, 브리핑 준비"처럼 걸어두면 됩니다. 아침 7시, 내 컴퓨터가 알아서 브리핑을 준비합니다!
핵심만 추림] B --> C[아침 브리핑
음성으로 재생] C --> D[스케줄러
매일 아침 7시 자동 실행]
연구 지원 에이전트는 논문과 메모 폴더를 연결해 로컬 지식 기반을 만들고, 인용을 달아 조사 결과를 정리합니다. 코드 지원 에이전트는 코드 실행과 파일 입출력, 셸 접근까지 맡습니다. 메시지 플랫폼과 연동하면 평소 쓰는 메신저에서 AI와 대화할 수도 있습니다.
스킬도 눈여겨볼 만합니다. 스킬은 그 자체가 도구입니다. 에이전트가 필요할 때 목록에서 찾아서 씁니다. 다른 스킬 모음에서 가져올 수도 있고, 공개된 표준을 따릅니다. 실행 명령도 간단합니다. jarvis를 치면 대화가 시작되고, jarvis gui를 치면 브라우저 대시보드가 열립니다. jarvis doctor는 설치 상태를 점검해줍니다.
무엇부터 해보면 좋을까요?
설치는 공식 설치 스크립트 한 줄로 시작합니다. 빠른 회선에서는 3분 정도면 끝나고, 큰 모델은 백그라운드에서 계속 내려받습니다. pip install openjarvis로 설치한 뒤 jarvis init으로 시작하는 방법도 있습니다. 맥OS, 윈도우, 리눅스를 지원하고, 명령줄과 브라우저 대시보드, 데스크톱 앱 중 편한 방식으로 쓰면 됩니다.
관심도 뜨겁습니다. 11월 기준 1만 5천 개가 넘는 별을 모았다는 소개도 있습니다. 다만 한 가지는 짚고 넘어가야 합니다. 로컬 실행의 체감은 내 하드웨어 성능에 달려 있습니다. 가벼운 대화와 요약은 작은 모델로 충분하지만, 무거운 작업은 기기 사양을 타게 됩니다. 그래도 방향은 분명합니다. 개인 AI의 미래는 하이브리드 설계, 로컬 기본 실행입니다!
GitHub 계정으로 로그인하여 댓글을 남겨보세요. GitHub 로그인
댓글 시스템 설정이 필요합니다
GitHub Discussions 기반 댓글 시스템을 활성화하려면:
- Giscus 설정 페이지에서 설정 생성
- GISCUS_SETUP_GUIDE.md 파일의 안내를 따라 설정 완료
- Repository의 Discussions 기능 활성화
Repository 관리자만 설정할 수 있습니다.